ChatGPTやBERTについて調べていると、必ず出てくるのが「Transformer(トランスフォーマー)」という言葉です。私もこれまで当ブログでSeq2Seq、BERT、GPTと個別に解説してきましたが、その間をつなぐTransformerそのものの仕組みは書いていませんでした。この記事では、数式に入り込み過ぎずに「Self-Attentionが何をしているのか」を直感的に説明し、最後にNumPyで実際に動く小さな実装まで作ってみます。
この記事の結論
- Transformerは、2017年の論文「Attention Is All You Need」(Vaswaniら)で提案された、RNNを使わずAttentionだけで系列を処理するモデルです。
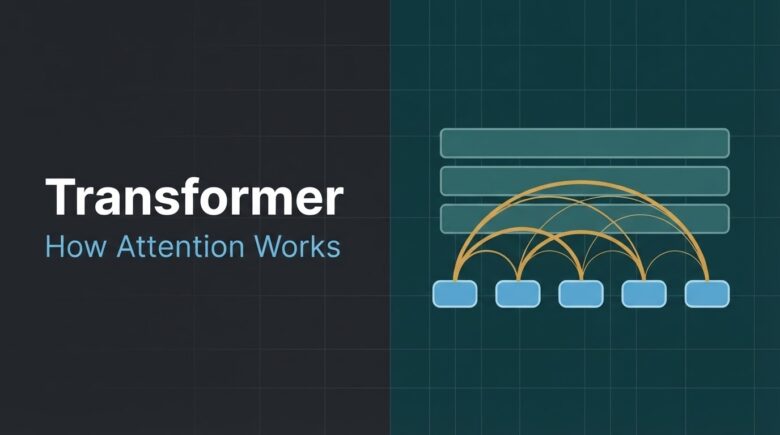
- 中心にあるSelf-Attentionは、文中の各単語が「どの単語にどれだけ注目するか」を重みとして計算し、文全体を一度に処理します。
- エンコーダ側を使ったのがBERT、デコーダ側を使ったのがGPTで、今のLLMの多くはこのTransformerを土台にしています。
- 核となる計算 softmax(QKT/√dk)V は、NumPyなら20行ほどで書けます。
Transformerとは?『Attention Is All You Need』の位置づけ
Transformerは、Googleの研究者を中心とするAshish Vaswaniらが2017年6月にarXivへ投稿した論文「Attention Is All You Need」(arXiv:1706.03762)で提案されたモデルです。タイトルの通り、それまで系列データの主役だったRNN(再帰型ニューラルネットワーク)や畳み込みを使わず、Attention(注意機構)だけで入力と出力の関係を表現するという点が画期的でした。
論文では機械翻訳で性能を確かめていて、要旨には次の結果が書かれています(出典:arXiv:1706.03762 Abstract)。
| タスク | 論文で報告されたBLEU |
|---|---|
| WMT 2014 英語→ドイツ語 | 28.4 |
| WMT 2014 英語→フランス語 | 41.8(単一モデル。8台のGPUで3.5日学習) |
私がこの論文を重要だと考えるのは、翻訳の精度そのものよりも「並列に計算できて、大きくしやすい構造」を示したことです。この性質があったからこそ、のちにBERTやGPTのような大規模な事前学習モデルが生まれました。言語モデル全体の流れは言語モデル(LM)の歴史をひも解く、そしてLLMへでまとめていますので、あわせて読んでみてください。
Seq2Seq(RNN)の限界とAttentionが生まれた理由
Transformer以前の機械翻訳では、Seq2Seq(エンコーダ・デコーダ型のRNN)が主流でした。Seq2Seqは入力文を1単語ずつ読み込んで「文脈ベクトル」にまとめ、そのベクトルから出力文を1単語ずつ生成します。この方式には大きく2つの弱点がありました。
- 逐次処理なので並列化しにくい:RNNは時刻tの計算に時刻t-1の結果が必要です。Vaswaniらの論文でも、この逐次的な性質が学習の並列化を妨げ、長い系列では特に問題になると指摘されています。
- 長い文で情報が薄まる:文全体を固定長のベクトル1つに押し込むため、文が長くなるほど前半の情報が失われやすくなります。
2つ目の問題に対して、Bahdanauらは2014年の論文(arXiv:1409.0473)で、固定長ベクトルがボトルネックになっていると考え、出力の各単語を生成するたびに入力文のどの部分に注目するかを学習する仕組みを提案しました。これがAttentionの原型です。
ただし、この時点のAttentionはあくまでRNNの「補助」でした。Transformerは発想を逆転させ、「Attentionが本体で、RNNは要らない」としたわけです。これで1つ目の並列化の問題も同時に解決しました。
Self-Attentionの仕組み:Query・Key・Valueを例文とたとえで理解する
Self-Attentionは、同じ文の中で、各単語がほかの単語とどれくらい関係しているかを計算する仕組みです。入力になるのは、各単語を数値のベクトルにしたもの(単語埋め込み)です。単語をベクトルにする考え方はWord Embeddingやword2vecの記事で詳しく解説しています。
例文で考える:「それ」は何を指す?
次の文を例にします。
「猫が魚を食べた。それはおいしかった。」
人間は「それ」が「魚」を指すとすぐにわかります。Self-Attentionでは、「それ」という単語のベクトルを作り直すときに、文中のすべての単語に対して「どれだけ参考にするか」という重みを割り振ります。うまく学習できたモデルなら、「魚」への重みが大きくなり、「それ」のベクトルに「魚」の情報が多く混ざります。イメージを表にすると次のようになります(数値ではなく、関係の強さのイメージです)。
| 「それ」から見た単語 | 猫 | 魚 | 食べた | おいしかった |
|---|---|---|---|---|
| 注目の強さ(イメージ) | 中 | 強 | 弱 | 中 |
重みは合計が1になるように正規化されるので、「どの単語に注目を配分するか」の割合だと考えるとわかりやすいです。
Query・Key・Valueの役割
この重みを計算するために、各単語のベクトルから3種類のベクトルを作ります。私は図書館の検索にたとえると理解しやすいと思っています。
| 名前 | 役割 | 図書館のたとえ |
|---|---|---|
| Query(Q) | 自分が探している情報 | 検索窓に入れるキーワード |
| Key(K) | 各単語が「何について持っているか」の見出し | 本の背表紙のタイトル |
| Value(V) | 実際に受け渡される中身 | 本の中身 |
計算の流れは次の3ステップです。
- QとKの内積で「相性」を測る:「それ」のQueryと、各単語のKeyの内積をとります。似た方向を向いているほど値が大きくなります。
- √dkで割ってsoftmaxにかける:値を合計1の重みに変換します。
- 重みでValueを足し合わせる:注目度の高い単語の中身ほど多く混ぜた、新しいベクトルができます。
これを式にすると、論文の式(1)になります。
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$$
\(\sqrt{d_k}\)で割る理由について、論文(第3.2.1節)では、「dkが大きいと内積の値が大きくなり、softmaxの勾配が極端に小さい領域に入ってしまう」と考えられるため、その影響を打ち消すために割っていると説明されています。割り算1つで学習が安定する、というのがScaled Dot-Product Attentionの「Scaled」の意味です。
なお、Q・K・Vは入力ベクトルに3つの重み行列をかけて作り、その重み行列は学習で決まります。ニューラルネットワークの重みや学習の基本はニューラルネットワークの基礎の記事で解説しています。
Multi-Head Attentionと位置エンコーディング
Multi-Head Attention:複数の視点で同時に注目する
単語同士の関係は1種類ではありません。「それ→魚」のような指示語の関係もあれば、「猫→食べた」のような主語と動詞の関係もあります。そこでTransformerでは、Q・K・Vを作る重み行列を複数セット用意し、別々のAttention(ヘッド)を並列に計算してから結合します。これがMulti-Head Attentionです。
論文の基本モデル(base model)では、次の値が使われています(出典:arXiv:1706.03762 第3.1節・第3.2.2節・第3.3節)。
| 項目 | 値 |
|---|---|
| エンコーダ・デコーダの層数 N | それぞれ6 |
| モデルの次元 dmodel | 512 |
| ヘッド数 h | 8 |
| 1ヘッドあたりの次元 dk=dv | 64(=512÷8) |
| Feed-Forward層の中間次元 dff | 2048 |
1ヘッドの次元を512÷8=64に落としているので、ヘッドを8つにしても計算量は1ヘッドで512次元を扱う場合とほぼ同じになる、というのが論文の説明です。PyTorchではこの仕組みがtorch.nn.MultiheadAttentionとして用意されていて、embed_dim(モデルの次元)とnum_heads(ヘッド数)を指定するだけで使えます。
位置エンコーディング:語順の情報を足す
Self-Attentionは全単語を一度に見るため、そのままでは「猫が魚を食べた」と「魚が猫を食べた」を区別できません。そこで入力の単語ベクトルに、位置ごとに決まったベクトルを足し込みます。論文ではsin・cosを使った次の式が使われています(第3.5節)。
$$PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d_{model}}}\right),\quad PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d_{model}}}\right)$$
posが単語の位置、iが次元の番号です。次元ごとに波の周期を変えることで、位置ごとに異なる「指紋」のようなベクトルができる、とイメージするとわかりやすいと私は思います。
エンコーダとデコーダの構造:BERTとGPTの違い
原論文のTransformerは、翻訳のためにエンコーダ(入力文を読む側)とデコーダ(出力文を書く側)の両方を持っています。エンコーダの各層は「Self-Attention+Feed-Forward」、デコーダの各層はそれに加えて「エンコーダの出力を見るAttention」を持ちます。
大事な違いは、デコーダのSelf-Attentionには「未来の単語を見ないマスク」がかかっていることです。文章を1単語ずつ生成するので、まだ書いていない単語を参照できては困るからです。
その後、このエンコーダ側だけを取り出して発展させたのがBERT、デコーダ側の構造を使って発展させたのがGPTです。BERTの名前自体が「Bidirectional Encoder Representations from Transformers」の略で、原論文の要旨でも、すべての層で左右両方の文脈を同時に使うことが特徴として書かれています。
| 項目 | BERT | GPT |
|---|---|---|
| 使うブロック | Transformerのエンコーダ | Transformerのデコーダ(エンコーダの出力を見る部分はなし) |
| 文脈の見方 | 左右両方(双方向) | 左側だけ(前の単語から次を予測) |
| マスク | 未来を隠すマスクなし(学習時は一部の単語を[MASK]に置き換えて当てさせる) | 未来の単語を隠すマスクあり |
| 得意なこと | 文の分類、質問応答、固有表現抽出など「読む」タスク | 文章の生成、対話など「書く」タスク |
| 提案 | 2018年 Devlinら(Google) | 2018年 Radfordら(OpenAI) |
ChatGPTのような対話AIはGPTの系統なので、「次の単語を予測する」デコーダの仕組みがベースになっています。
NumPyでScaled Dot-Product Attentionを実装してみる
ここまでの内容を、実際にコードで確かめてみます。私の環境(Python 3.12.1、NumPy 1.26.4)で実行しました。単語ベクトルと重み行列は学習していない乱数なので、出てくる重みの値そのものには意味がありません。見てほしいのは「行列の形」と「重みの合計が1になること」「マスクで未来が0になること」です。
import numpy as np

print("NumPy", np.__version__)

def softmax(x, axis=-1):
    x = x - np.max(x, axis=axis, keepdims=True)  # オーバーフロー対策
    e = np.exp(x)
    return e / np.sum(e, axis=axis, keepdims=True)

def scaled_dot_product_attention(Q, K, V, mask=None):
    d_k = Q.shape[-1]
    scores = Q @ K.T / np.sqrt(d_k)          # (系列長, 系列長)
    if mask is not None:
        scores = np.where(mask, scores, -1e9)  # 見せたくない位置を消す
    weights = softmax(scores, axis=-1)       # 各行の合計が1になる
    return weights @ V, weights

rng = np.random.default_rng(0)
tokens = ["私", "は", "猫", "が", "好き"]
seq_len, d_model, d_k = len(tokens), 8, 4

X = rng.normal(size=(seq_len, d_model))    # 単語ベクトル(今回は乱数)
W_q = rng.normal(size=(d_model, d_k))
W_k = rng.normal(size=(d_model, d_k))
W_v = rng.normal(size=(d_model, d_k))

Q, K, V = X @ W_q, X @ W_k, X @ W_v
out, w = scaled_dot_product_attention(Q, K, V)

np.set_printoptions(precision=2, suppress=True)
print("出力の形:", out.shape)
print("重みの行の合計:", w.sum(axis=1))
print("「猫」から各単語への重み:")
for t, a in zip(tokens, w[2]):
    print(f"  {t}: {a:.2f}")

# GPT(デコーダ)のように「未来の単語を見ない」マスク
causal = np.tril(np.ones((seq_len, seq_len), dtype=bool))
_, w_masked = scaled_dot_product_attention(Q, K, V, mask=causal)
print("マスクありの重み:")
print(w_masked)
実行結果は次の通りです。
NumPy 1.26.4
出力の形: (5, 4)
重みの行の合計: [1. 1. 1. 1. 1.]
「猫」から各単語への重み:
  私: 0.80
  は: 0.19
  猫: 0.00
  が: 0.00
  好き: 0.01
マスクありの重み:
[[1.   0.   0.   0.   0.  ]
 [1.   0.   0.   0.   0.  ]
 [0.81 0.19 0.   0.   0.  ]
 [0.   0.01 0.98 0.01 0.  ]
 [0.   0.45 0.04 0.51 0.  ]]
ポイントを整理します。
- 出力の形が(5, 4):5単語それぞれについて、ほかの単語の情報を混ぜた新しいベクトル(4次元)ができています。
- 各行の合計が1:softmaxによって、注目の「配分」になっていることが確認できます。
- マスクありでは右上がすべて0:
np.trilで作った下三角のマスクにより、各単語は自分より前の単語しか見ていません。1行目の「私」は自分自身しか見られないので重みが1になります。これがGPTのデコーダで使われている考え方です。
実際のTransformerでは、この計算をヘッドの数だけ並列に行い(Multi-Head)、その後にFeed-Forward層や残差接続・Layer Normalizationを重ねた層を何段も積み上げています。とはいえ、中心にある計算は上の20行ほどのコードと同じです。
まとめ:TransformerがLLMの土台になった理由
最後に、この記事の内容を振り返ります。
- Seq2Seq(RNN)には「並列化しにくい」「長い文で情報が薄まる」という限界があり、Bahdanauらの注意機構がその改善の糸口になりました。
- Transformerは2017年にAttentionだけで系列を処理する構造を示し、文全体を一度に並列計算できるようになりました。
- Self-AttentionはQuery・Key・Valueを使い、各単語が文中のどこに注目するかを重みとして計算します。
- エンコーダを使ったBERT、デコーダを使ったGPTへと分かれ、GPTの系統が今の対話型AIにつながっています。
私は、TransformerがLLMの土台になった一番の理由は「並列計算できるので、データとモデルを大きくするほど性能を伸ばしやすかった」ことだと考えています。RNNのままでは、今のような巨大なモデルを現実的な時間で学習させるのは難しかったはずです。
LLMの活用へ
Transformerの仕組みがわかると、LLMを「どう使うか」の話も理解しやすくなります。外部の文書を検索して回答の精度を上げる手法はRAG(検索拡張生成)の解説記事、LLMに自律的にタスクをこなさせる仕組みはAIエージェントの解説記事で紹介していますので、次のステップとしてぜひ読んでみてください。
参考
- Vaswani et al., “Attention Is All You Need”, arXiv:1706.03762 https://arxiv.org/abs/1706.03762
- Bahdanau et al., “Neural Machine Translation by Jointly Learning to Align and Translate”, arXiv:1409.0473 https://arxiv.org/abs/1409.0473
- Devlin et al., “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”, arXiv:1810.04805 https://arxiv.org/abs/1810.04805
- Radford et al., “Improving Language Understanding by Generative Pre-Training”(OpenAI, 2018) https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- PyTorch公式ドキュメント torch.nn.MultiheadAttention https://pytorch.org/docs/stable/generated/torch.nn.MultiheadAttention.html
- NumPy公式ドキュメント numpy.tril https://numpy.org/doc/stable/reference/generated/numpy.tril.html
※論文の数値は各論文のarXiv掲載版(2026年11月1日確認)によります。コードの実行環境はPython 3.12.1、NumPy 1.26.4です。